Über uns
Karriere bei uns
Gestalten Sie mit uns die digitale Zukunft des öffentlichen Verkehrs. Bei ETC Solutions arbeiten Sie an Lösungen, die den Betrieb effizienter machen und Fahrgäste verlässlich informieren in einem Umfeld mit Verantwortung, Gestaltungsspielraum und echtem Impact.
Warum ETC Solutions?

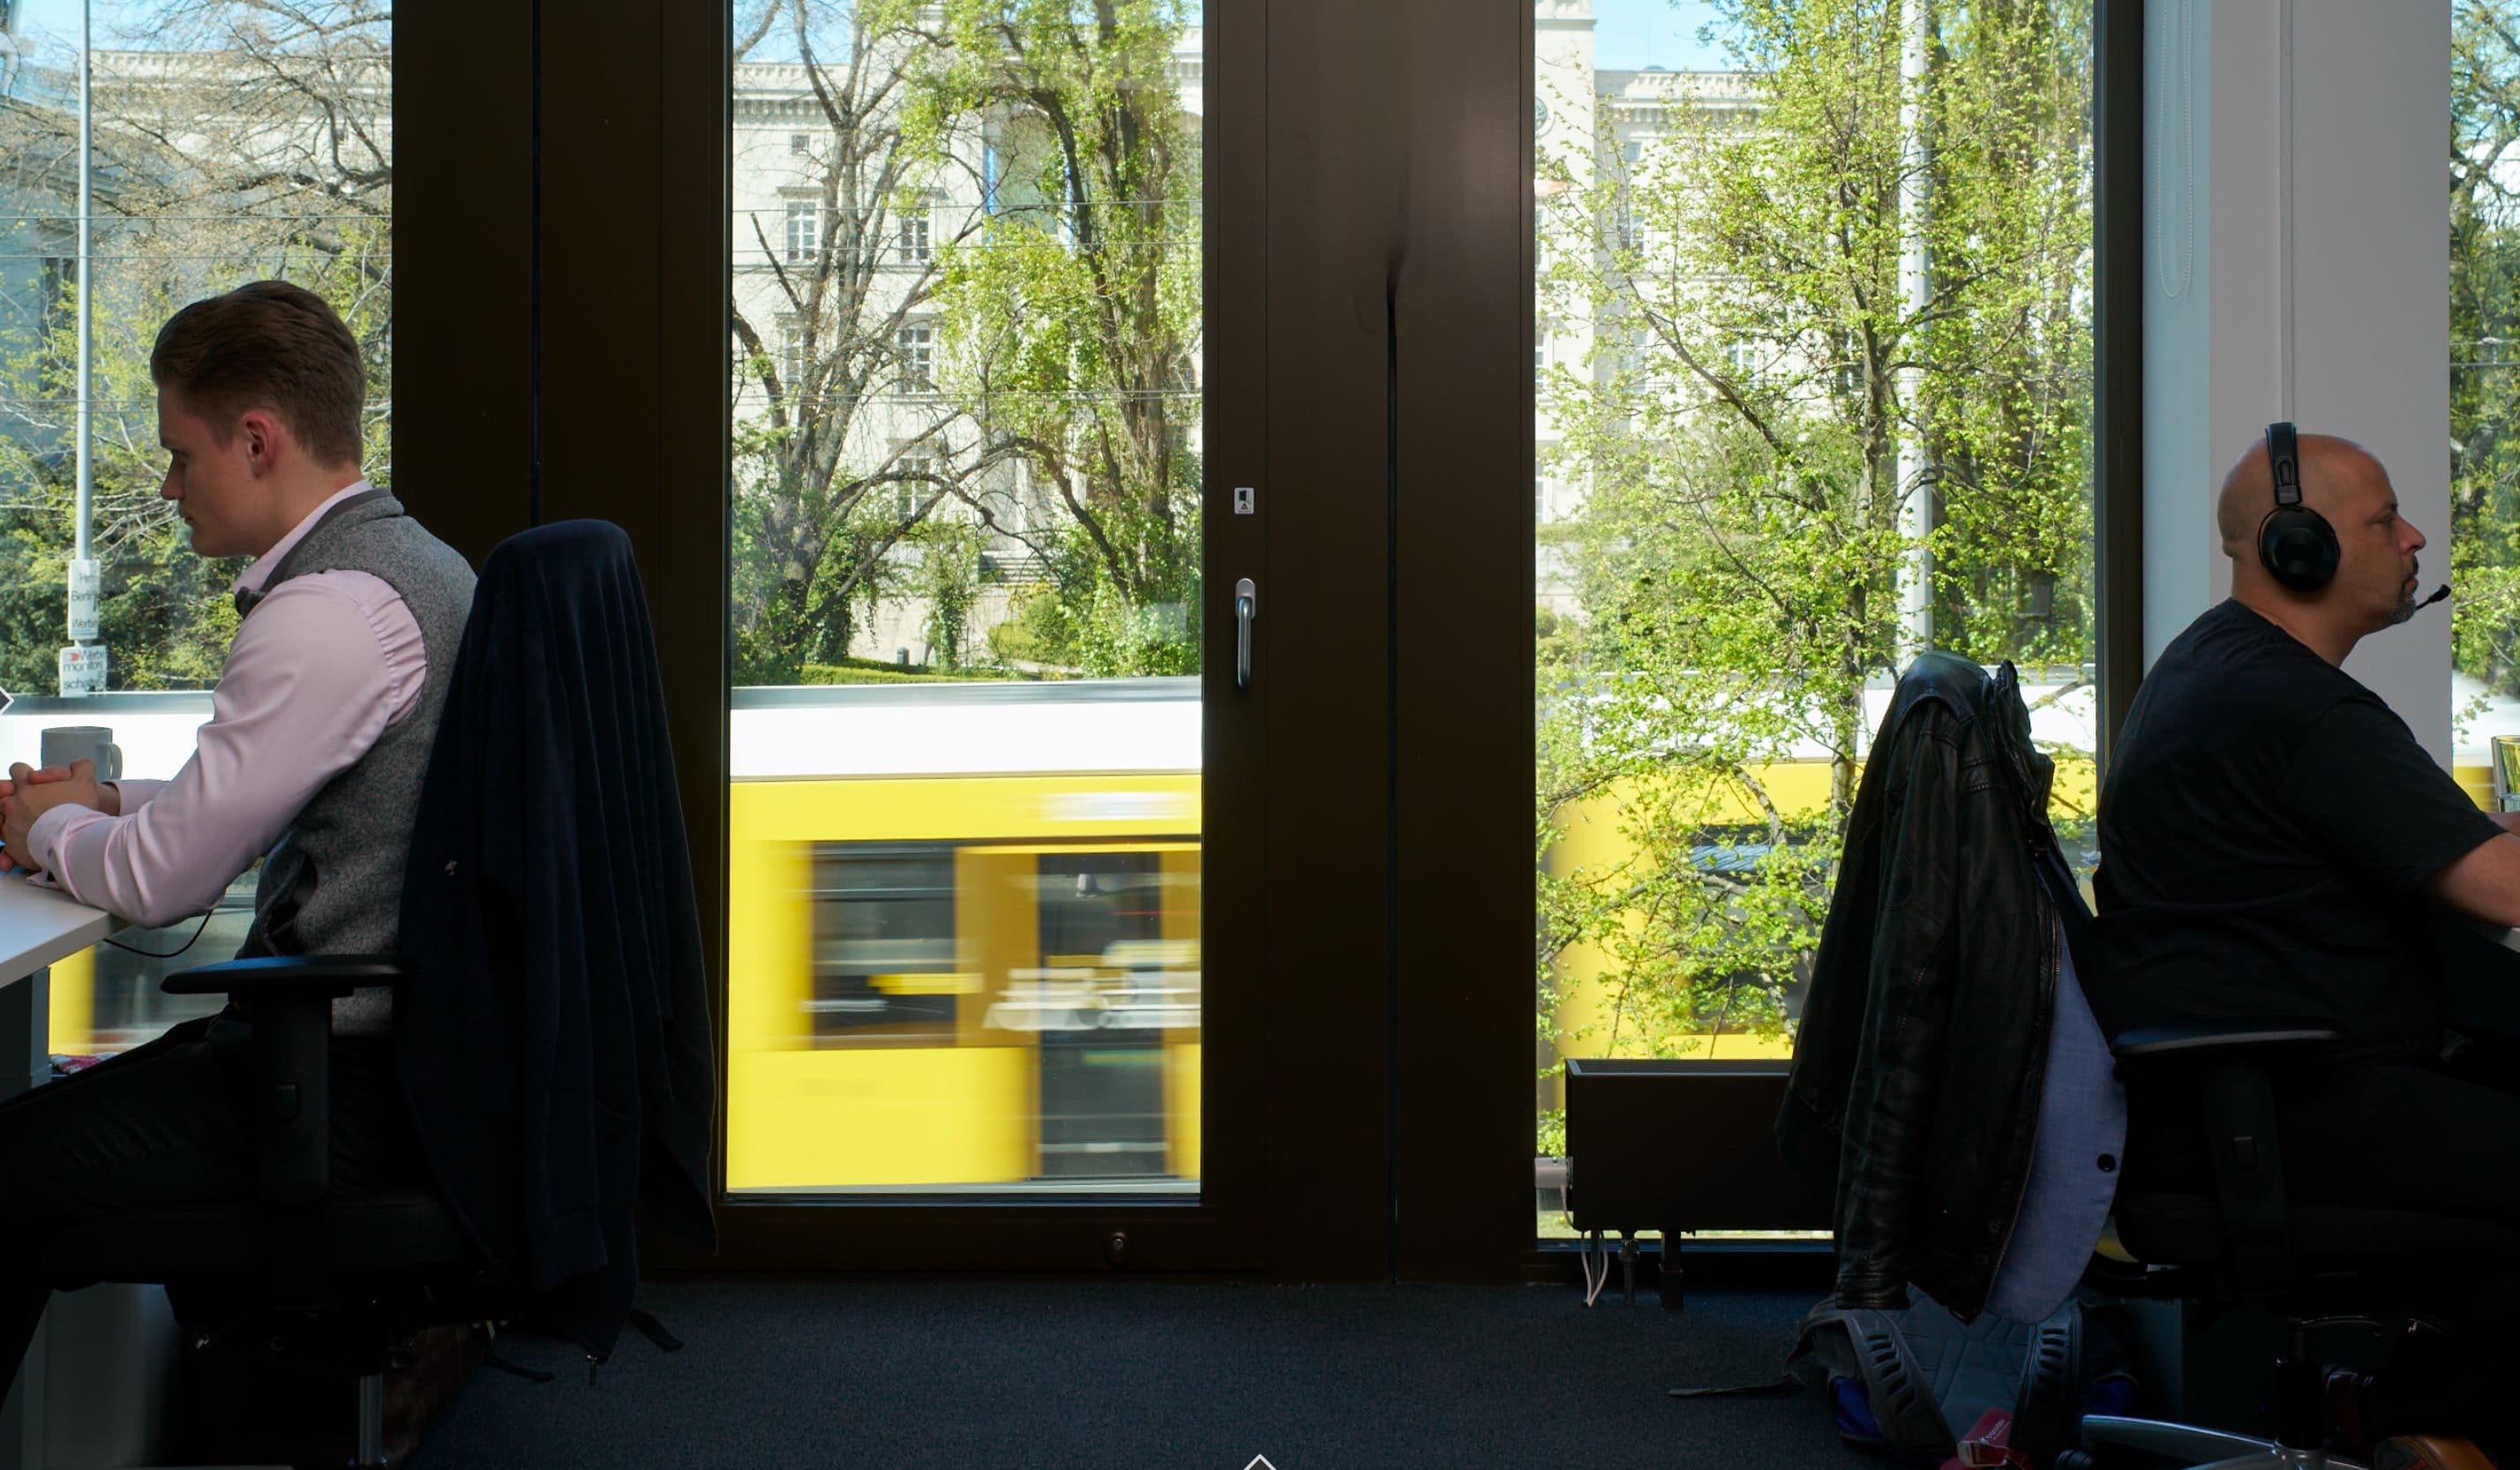
Sinnstiftende Projekte im ÖPNV mit direkter Wirkung im Alltag
Spannende Aufgaben an der Schnittstelle von Technologie, Betrieb und Daten
Kurze Wege & echte Mitgestaltung – Ideen und Engagement sind ausdrücklich willkommen
Offene, wertschätzende Kultur, in der neue Ansätze ihren Platz finden
So arbeiten wir
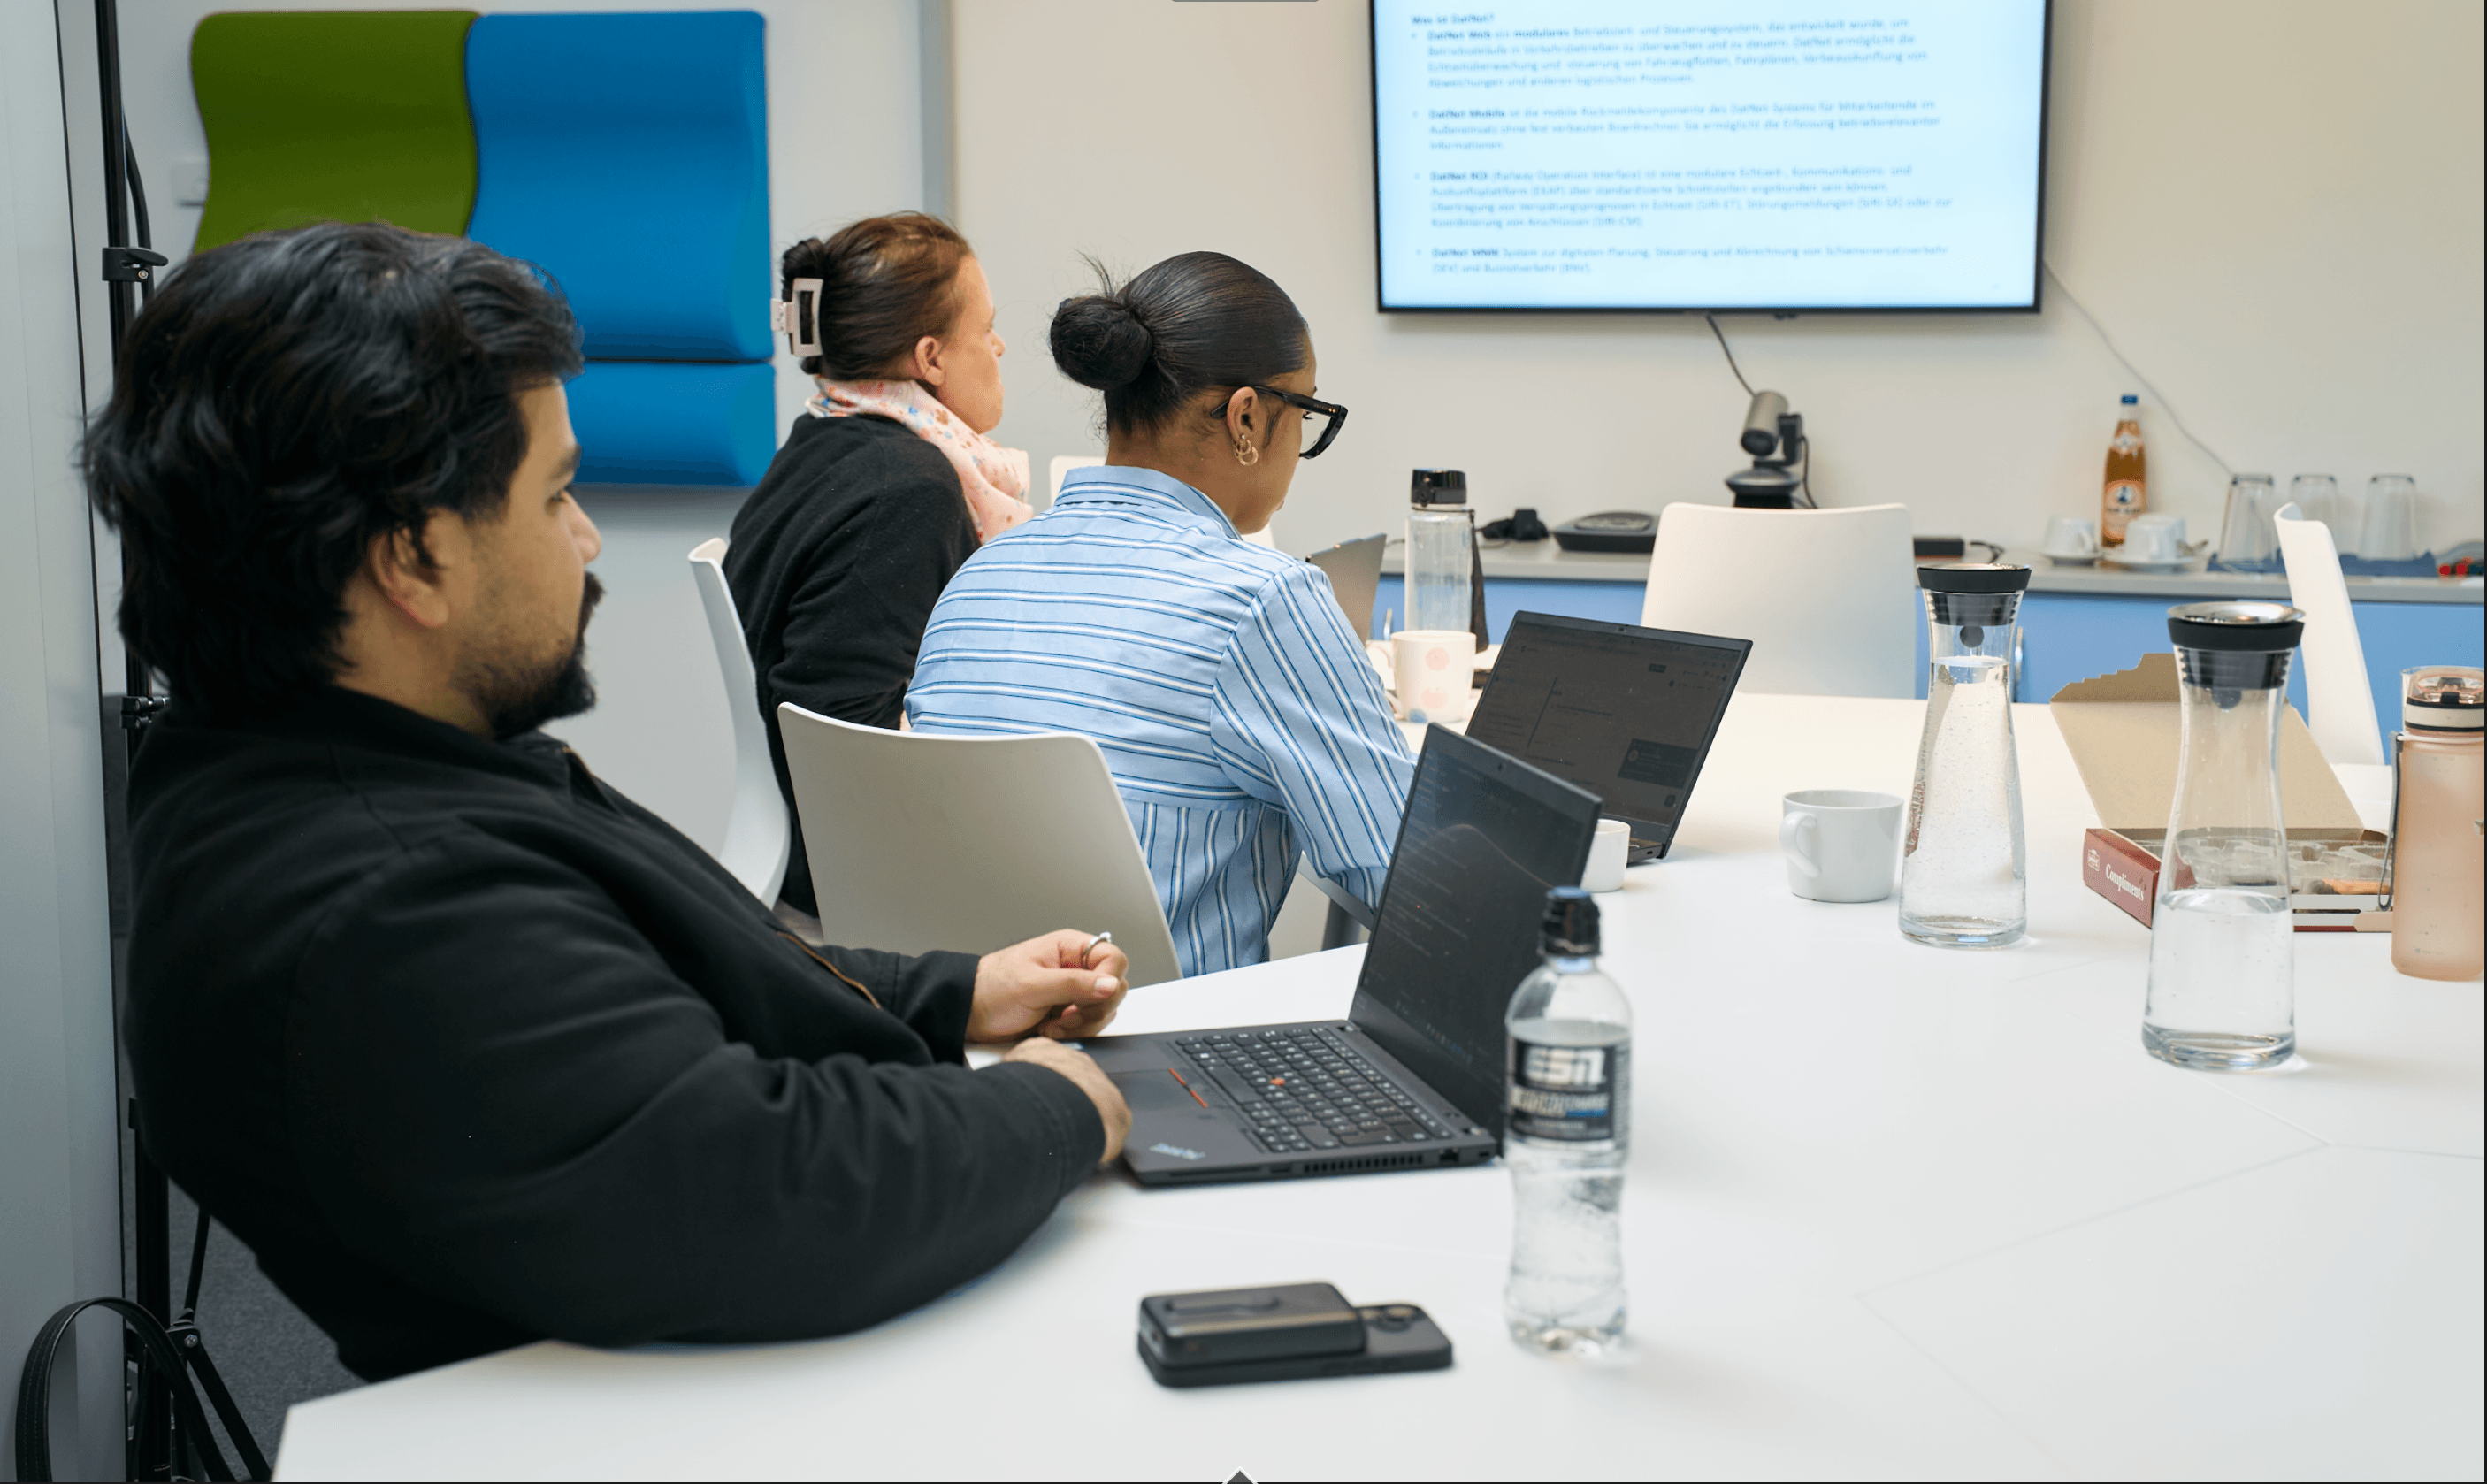
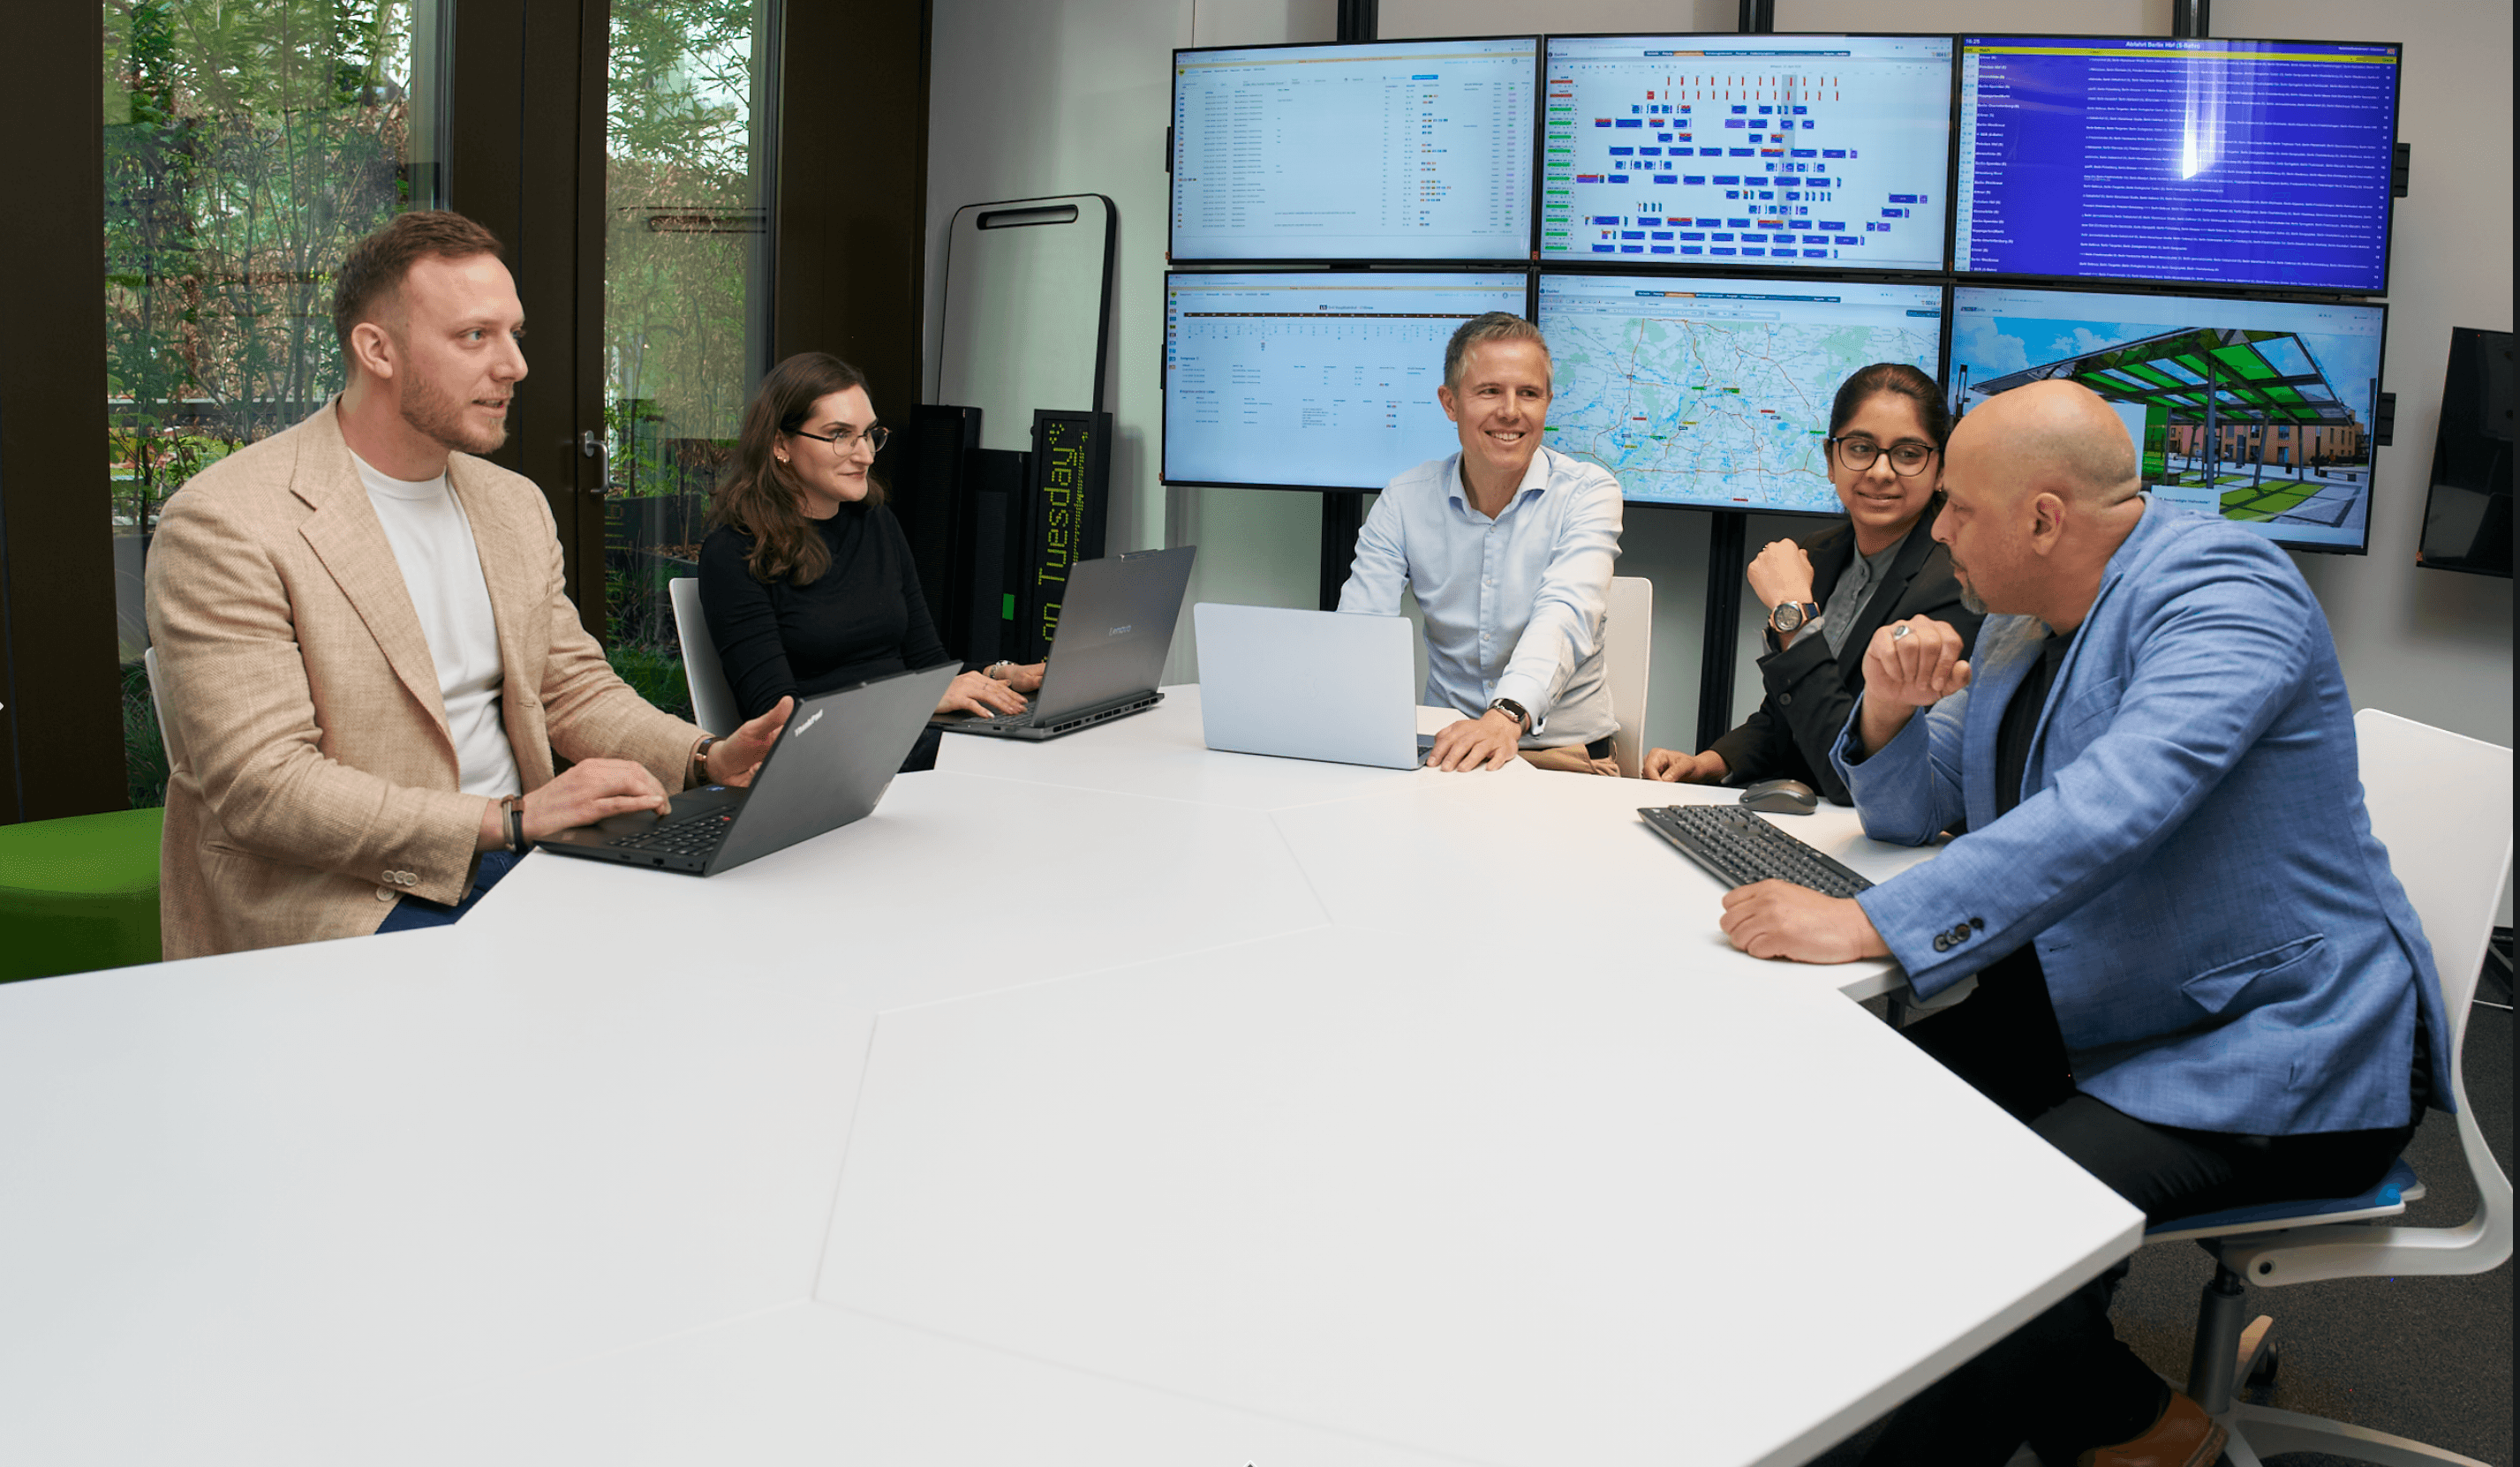
Interdisziplinär, pragmatisch und partnerschaftlich: Wir arbeiten eng mit Verkehrsunternehmen, Aufgabenträgern und Industriepartnern zusammen mit einem hohen Anspruch an Stabilität, Verständlichkeit und nachhaltige Lösungen.
Wir bieten

Ein abwechslungsreiches und verantwortungsvolles Aufgabengebiet in einem innovativen Unternehmen
Viel Raum für persönliche und fachliche Weiterentwicklung
Eine offene und wertschätzende Unternehmenskultur, in der Kreativität und neue Ideen willkommen sind
Ein modernes Arbeitsumfeld mit flexiblen Arbeitszeiten und der Option auf Homeoffice
Weiterbildungsmöglichkeiten, die Sie in Ihrer Entwicklung unterstützen
Betriebliche Altersvorsorge zur langfristigen Absicherung
Ein engagiertes und kollegiales Team, das gemeinsam Ziele erreicht
JobRad-Leasing für umweltfreundliche Mobilität
Zuschuss zum ÖPNV-Ticket zur Unterstützung Ihrer Anfahrt
Exklusive Vergünstigungen bei zahlreichen Partnern über unser Corporate-Benefits-Programm
Regelmäßige Team-Events zur Stärkung des Zusammenhalts
Offene Stellen
Monitoring & Observability Engineer (m/w/d) – Cloud-Infrastruktur & SaaS
Standort: Berlin · Remote · Hybrid
Anstellungsart: Vollzeit (unbefristet)
Branche: Softwareentwicklung · Eisenbahntechnologie (SaaS · KRITIS)
Aufgaben
Grafana als Single Point of Truth: Sie konzipieren, implementieren und optimieren unsere zentrale End-to-End Observability-Architektur in der OVHcloud, mit dem Ziel, sämtliche Telemetriedaten in Grafana als zentraler Plattform zusammenzuführen.
Technisches Service- & Infrastruktur-Monitoring: Sie stellen das lückenlose Metriken- und Log-Monitoring unserer containerisierten Anwendungen und Services in den Kubernetes-Clustern mittels Prometheus und Loki sicher.
Datenbank- & Fachliches Monitoring: Sie überblicken die über den Zalando Postgres Operator orchestrierten PostgreSQL-Datenbanken. Mittels gezielter SQL-Abfragen, die Sie direkt in Grafana einbinden, kontrollieren Sie sowohl die technische Performance als auch die inhaltliche Korrektheit der Anwendungsdaten (z. B. Datenintegrität, Verarbeitungsstatus von Echtzeit- und Fahrplandaten, Systemdurchsatz).
Befähigung & Coaching der Entwicklung (Enablement): In enger Abstimmung mit dem Leiter Engineering schulen und unterstützen Sie unser Software-Engineering-Team bei der optimalen Nutzung von Prometheus. Hierzu erarbeiten Sie exemplarische Vorgaben, Code-Beispiele und Best Practices, damit neue Software-Services von Beginn an standardisiert mit den passenden Metriken ausgestattet sowie bestehende Services systematisch und sauber für das Monitoring nachgerüstet werden.
Strategische Priorisierung der Monitoring-Landschaft: Sie analysieren unsere Systemlandschaft und entscheiden in enger Abstimmung mit dem Leiter Support und dem Leiter Engineering, welche Dienste und Services priorisiert überwacht und tiefgreifend analysiert werden müssen, um geschäftskritische Engpässe frühzeitig abzufangen.
Zielgerichtetes Alerting & Dokumentation via Jira & MS Teams: Sie definieren intelligente, rauscharme Alerting-Regeln direkt im Grafana-Setup. Bei technischen Anomalien oder fachlichen Diskrepanzen stellen Sie sicher, dass Vorfälle vollautomatisch oder strukturiert zur lückenlosen Nachverfolgung als Ticket in Jira dokumentiert und anschließend zur schnellen Benachrichtigung des Teams in Microsoft Teams ausgespielt werden.
Arbeitsorganisation & Dokumentation via Jira: Die gesamte Planung, Steuerung und lückenlose Dokumentation Ihrer Aufgaben, Projekte und Monitoring-Konzepte erfolgt strukturiert innerhalb unserer Jira-Landschaft.
Schnittstellenfunktion & Incident Response: Organisatorisch sind Sie direkt beim Leiter Support angesiedelt. Sie arbeiten eng mit unserem DevOps- und Software-Engineering-Team zusammen und unterstützen aktiv bei der Ursachenanalyse (Root Cause Analysis) von ungeplanten Systemzuständen.
Ihr Profil
Berufserfahrung: Fundierte Erfahrung im Bereich IT-Monitoring, Site Reliability Engineering (SRE) oder Systemadministration in hochverfügbaren Cloud-Umgebungen.
SQL- & Datenbank-Kenntnisse: Sie bringen ein gutes Verständnis für relationale Datenbanken (idealerweise PostgreSQL) mit und verfügen über solide SQL-Basiskenntnisse, um grundlegende Abfragen zur Visualisierung von Kennzahlen direkt in Grafana zu erstellen.
Stack-Expertise & Lernbereitschaft: Sie bringen ein gutes Grundverständnis für den Stack aus Grafana, Prometheus und Loki (oder vergleichbaren Tools) mit. Da wir uns stetig weiterentwickeln, ist uns Ihre Bereitschaft wichtig, sich tiefgehendes Know-how in diesen Technologien und den Jira-/Teams-Integrationen selbstständig anzueignen.
Infrastruktur-Know-how: Sicherer Umgang mit Cloud-Infrastrukturen (idealerweise OVHcloud · OpenStack) sowie solide Kenntnisse im Umgang mit Kubernetes und Docker (bzw. containerisierten Umgebungen).
Projekt- & Tool-Kompetenz: Erfahrung in der strukturierten Arbeitsorganisation und Dokumentation mit Jira sowie gute Scripting-Kenntnisse (z. B. Bash, Python, Go) zur Automatisierung von Monitoring-Tasks.
Mentalität: Stark ausgeprägtes logisches und prozessuales Verständnis, gepaart mit hoher KRITIS-Verantwortung, ausgeprägter Teamfähigkeit und Freude am Wissenstransfer und Coaching.
Sie möchten bei uns einsteigen?
Sie interessieren sich für ETC Solutions, haben aber keine passende Stelle gefunden? Dann freuen wir uns jederzeit über Ihre Initiativbewerbung. Schicken Sie uns einfach Ihren Lebenslauf an personal@etc-consult.de.